一、🎯 企业数据仓库的角色与目标定位
1.1 数据仓库在企业中的核心价值
在进行数据仓库设计之前,必须先明确它在企业数据架构中的定位。数据仓库(Data Warehouse)通常承担以下角色:
- 面向分析与决策,而非 OLTP 事务处理
- 汇总多源数据,构建统一、可信的“企业数据标准视图”
- 支持报表、BI、数据分析、数据挖掘、机器学习等多种下游应用
- 为高层管理、中层运营、基层业务提供不同粒度的指标与明细数据
与业务系统数据库相比,数据仓库更关注:
| 对比维度 | 业务系统(OLTP) | 数据仓库(OLAP) |
|---|---|---|
| 主要用途 | 事务处理、业务流程支撑 | 分析决策、统计报表、趋势洞察 |
| 数据结构 | 面向业务流程,强调范式化 | 面向分析主题,常用维度建模或 Data Vault |
| 更新方式 | 高频增删改 | 批量装载、追加为主,少量更新 |
| 时间跨度 | 近期数据,强调实时一致 | 长期历史数据,强调时序与可追溯性 |
| 查询模式 | 单记录读写 | 大量聚合、关联、扫描 |
| 性能优化方向 | 写入/事务性能 | 复杂查询和多维分析性能 |
企业想要 高效满足业务数据需求 ,必须在一开始就明确:
数据仓库是企业“决策中枢”的数据基础设施,而不仅仅是“报表数据库”。
1.2 与数据湖、数据集市的关系
现代数据架构中,数据仓库不再是唯一核心,还有数据湖、数据集市等概念:
- 数据湖(Data Lake) :
- 存储结构化、半结构化、非结构化数据
- 常用对象存储(如 AWS S3、Azure Blob、阿里云 OSS 等)
- 原始数据粒度高,适合大数据分析、机器学习模型训练
- 数据仓库(Data Warehouse) :
- 主要关注结构化、面向分析的数据
- 强调建模、治理、财务口径、统一指标
- 更适合自助分析、固定报表、合规审计
- 数据集市(Data Mart) :
- 面向部门或主题的子仓库,如营销集市、供应链集市
- 可以从数据仓库或数据湖中抽取整理
- 便于团队快速使用数据
典型组合方式:
- 数据湖存 原始数据 & 非结构化数据
- 数据仓库存 清洗后、高度治理的分析数据
- 数据集市针对具体业务团队做 定制优化和聚合
在设计数据仓库时,要明确它与湖、集市的分工,避免重复建设与口径冲突。
二、🧭 数据仓库需求分析:从业务出发
2.1 需求分析的核心思路
高效满足企业需求的前提,是从业务场景出发,而不是从技术出发。 数据仓库需求分析可以分为以下几个方向:
- 业务场景与决策问题
- 领导层要看哪些经营指标?
- 运营团队要监控哪些实时/准实时数据?
- 哪些部门要进行历史分析、对比分析?
- 指标体系与口径定义
- 核心指标(GMV、订单量、客单价、毛利率等)
- 维度(时间、地区、渠道、产品、客户等)
- 口径统一(订单取消是否统计?退款如何统计?)
- 数据来源系统
- ERP、CRM、WMS、SCM、POS、电商平台、第三方广告平台、IoT 等
- 每个系统数据结构、更新频率、数据质量现状
- 性能与时效要求
- 报表刷新频率(实时、分钟级、小时级、T+1)
- 查询并发量、访问量峰值
- 历史保留年限
- 安全与权限
- 不同角色能看到哪些数据?
- 跨部门访问是否需要脱敏?
- 审计与日志要求?
2.2 需求分析常用方法与模板
可采用以下方法系统化收集需求:
- Stakeholder 访谈
- 高层:战略决策类指标
- 中层:运营监控、KPI 跟踪
- 基层:日常操作报表、任务看板
- 报表盘点
- 现有报表清单整理(Excel、BI 工具、系统导出)
- 识别重复报表、无效报表、关键报表
- 流程梳理与数据流向分析
- 订单从创建、支付、发货、签收、退货等全流程
- 库存从入库、上架、移库、出库、盘点等全流程
下表是一个简化的需求收集模板示例:
| 维度 | 问题示例 |
|---|---|
| 业务目标 | 要解决的决策问题是什么? |
| 核心指标 | 需要哪些 KPI?如何定义? |
| 数据粒度 | 订单级?明细SKU级?客户级? |
| 数据时效 | T+1 即可?需要小时级或实时? |
| 历史跨度 | 需要保存几年数据? |
| 报表与分析方式 | 固定报表 / 自助分析 / 数据 API? |
| 使用人群 | 管理层 / 运营 / 财务 / 数据分析师? |
| 权限与合规 | 有哪些隐私、财务合规要求? |
| 性能期望 | 高峰期并发查询量、多大数据量下需要秒级响应? |
在这个阶段就把 数据仓库设计要求 记清楚,将直接影响后续的分层、建模、技术选型。
三、🏗 数据仓库总体架构设计与数据分层
3.1 常见数据仓库架构模式
现代数据仓库常见三类架构形态:
- 传统集中式数仓架构(EDW)
- 企业统一数据仓库,所有主题统一建模
- 优点:口径统一、治理规范
- 缺点:建设周期长,对于快速变化的业务响应慢
- 领域驱动的数据中台/数据网格(Data Mesh)
- 按业务域划分数据产品和责任边界
- 强调各域自治与跨域协作
- 更适合大型、复杂组织
- 湖仓一体架构
- 利用统一存储和计算引擎,兼具湖的灵活与仓的治理能力
- 如 Databricks Lakehouse、Amazon Redshift + S3 生态等
企业在设计时,应根据现状(组织规模、团队能力、历史遗留系统)选择架构,并保证 可演进 :可以从集中式数仓起步,逐步向领域化、湖仓一体演进。
3.2 分层架构设计(ODS/DWD/DWS/ADS 等)
多数数据仓库会采用 数据分层 策略,以减少耦合、提高可维护性。典型分层如下(名称略有差异,但思想相似):
| 分层名称 | 英文缩写 | 主要作用 |
|---|---|---|
| 原始层 | ODS | 贴源存储,多源数据原始落地,轻度清洗 |
| 明细层 | DWD | 标准化后的明细事实层,粒度清晰,保证一致性 |
| 汇总层 | DWS | 按常用分析主题预聚合,提高查询性能 |
| 应用层 | ADS/APP | 面向具体报表、数据服务的宽表或数据接口 |
| 维度层 | DIM | 公共维度数据,如时间、地域、产品、客户等 |
| 元数据层 | Meta | 存储数据字典、血缘、质量规则等 |
数据分层的核心目标:
- 降低 ETL 复杂度和重复开发
- 让各层职责清晰、依赖稳定
- 方便定位问题和监控数据质量
3.3 分层示例:订单主题的分层设计
以“订单”主题为例,各层可能包含:
- ODS 层
- ods_order_raw :从电商系统拉取的原始订单表
- ods_payment_raw :支付平台回调记录
- ods_refund_raw :退款记录
- DWD 层
- dwd_order_detail :统一订单明细事实表(含标准字段、状态码统一)
- dwd_payment_detail :支付明细事实表
- dwd_refund_detail :退款明细事实表
- DWS 层
- dws_order_sku_day :按日期、SKU 汇总的订单统计
- dws_order_channel_day :按渠道、地区汇总的订单统计
- ADS 层
- ads_gmv_dashboard :供经营大盘使用的宽表
- ads_marketing_campaign :供营销活动分析的宽表
通过分层,系统可以兼顾 灵活性(明细层适合 ad-hoc 分析) 和 性能(汇总层提升常用查询速度) 。
四、📐 数据建模:维度建模、三范式与 Data Vault
4.1 为什么数据建模是数据仓库设计的核心
建模决定了数据仓库的:
- 可读性与可理解性
- 指标的一致性与可复用性
- 查询复杂度与性能
- 扩展性与演进成本
企业级数仓常见三种建模方法:
- 维度建模(Dimensional Modeling)
- ER/三范式建模(3NF)
- Data Vault 建模
各有适用场景。
4.2 维度建模:事实表与维度表
维度建模 是数据仓库最经典的方法,由 Kimball 体系提出。核心概念:
- 事实表(Fact Table) :
- 存储可加度事实(指标),如订单金额、数量、点击次数
- 粒度清晰,如“订单明细级”、“日级汇总级”等
- 包含多个维度键(外键) + 度量值
- 维度表(Dimension Table) :
- 描述事实的业务属性,如产品、客户、时间、地区等
- 通常是“宽表”,便于自助分析
- 支持层级属性(如地区:国家-省-市)
示例:订单明细事实表 fact_order_detail :
| 字段名 | 类型 | 说明 |
|---|---|---|
| order_id | BIGINT | 订单ID |
| order_line_id | BIGINT | 订单行ID |
| customer_key | BIGINT | 客户维度外键 |
| product_key | BIGINT | 产品维度外键 |
| date_key | INT | 日期维度外键(如20260428) |
| channel_key | BIGINT | 渠道维度外键 |
| quantity | INT | 购买数量 |
| order_amount | DECIMAL | 订单金额 |
| discount_amount | DECIMAL | 折扣金额 |
| net_amount | DECIMAL | 实付金额 |
优势:
- 面向业务主题,易于理解
- 结合星型/雪花模型,适合 BI 工具和多维分析
- 查询性能好(少量事实表 join 维表)
4.3 三范式建模(3NF):强调业务关系与一致性
三范式建模源于传统 OLTP 设计,也可用于数据仓库的 企业数据仓库层(EDW) ,特点:
- 高度规范化,减少冗余
- 更接近业务系统的实体关系结构
- 对变更敏感,灵活性略逊于维度建模
适用场景:
- 需要保持与业务系统高度一致
- 重视实体关系完整性和强一致性
- 作为维度建模之前的“集成层”
在大多数现代实践中,会采用 3NF + 维度建模混搭 :
- 用 3NF 做企业集成层(便于整合多系统)
- 用维度建模为具体主题构建数据集市或主题层
4.4 Data Vault:面向变化的模型
Data Vault 建模由 Dan Linstedt 提出,更适合数据源频繁变更、历史追踪要求高的场景。核心组件:
- Hub(核心实体) :如客户、订单、产品等,存储业务键
- Link(关联) :描述 Hub 之间的关系
- Satellite(卫星) :存储实体属性和历史变化
特点:
- 结构高度稳定,适应源系统字段与结构频繁变化
- 对历史的记录非常完整,适合审计场景
- 建模和查询复杂度较高,需要更多工具支持
适用企业:
- 行业监管严格(金融、保险、能源等)
- 多源系统、并购频繁、业务合并复杂
- 对可追溯性与历史完整性有强约束
4.5 如何选择建模方法?
可用下表做一个简单判断:
| 需求/特征 | 推荐建模方法 |
|---|---|
| 注重报表、BI、自助分析 | 维度建模 |
| 注重实体关系、业务系统映射 | 3NF + 维度建模 |
| 源系统经常变化、需要审计历史 | Data Vault + 维度建模 |
| 团队经验以 Kimball 为主 | 维度建模为主 |
| 组织大型、数据治理要求极高 | 3NF + Data Vault + 维度建模混合 |
现实项目中常采用组合策略:
源系统 → ODS(贴源结构) → EDW/3NF 或 Data Vault → 维度模型(DWD/DWS) → 应用层(ADS)
五、⚙️ ETL/ELT 流程设计与数据集成
5.1 ETL 与 ELT 的区别与选择
两种常见数据加载方式:
- ETL(Extract-Transform-Load)
- 在进入数据仓库前完成主要转换与清洗
- 常见于传统本地数仓、专用 ETL 工具场景
- ELT(Extract-Load-Transform)
- 先快速加载到数据仓库 / 数据湖,由数仓自身进行转换
- 常见于云数据仓库(如 Snowflake、BigQuery、Redshift、ClickHouse 等)
云时代由于计算分离 & 存储便宜,ELT 越来越流行,但无论 ETL 或 ELT,都需要注意:
- 源系统影响最小(避免拖垮生产)
- 数据抽取可增量可全量,支持断点续跑
- 转换逻辑透明、可追踪,减少黑盒
5.2 数据抽取层设计要点
抽取层关注:
- 抽取方式:JDBC、API、CDC(变更数据捕获)、文件导出等
- 调度频率:实时、准实时、T+1、T+N
- 容错与重试:网络抖动、API 限流应对策略
- 落地格式:Parquet、ORC、CSV、JSON 等(数据湖场景)
为减少对业务库的压力,可采用:
- 数据库 Binlog / WAL 级别的 CDC 工具,如 Debezium、Oracle GoldenGate 等
- 使用只读实例进行抽取
- 控制抽取时间窗口,在业务低峰期执行全量
5.3 数据转换与清洗策略
数据清洗与转换是保证数据质量的关键环节,常见处理包括:
- 格式标准化(日期格式、货币、小数精度等)
- 编码与状态码统一(订单状态、渠道编码)
- 去重与合并(重复订单、重复日志)
- 异常值处理(缺失值、异常数值)
- 主数据映射(产品、客户、供应商统一编码)

在设计数据转换流程时,应:
- 尽量将通用规则沉淀为可复用组件
- 在代码或配置层面保留数据血缘信息(字段来源)
- 为关键转换加上“审计字段”(处理时间、处理批次、来源系统标识等)
5.4 ETL/ELT 工具与编排
常见的开源/云端工具有:
- 工作流/调度:Apache Airflow、Dagster、Prefect 等
- 流式处理:Apache Kafka、Flink、Spark Streaming 等
- 数据集成:Fivetran、Stitch、Talend、Informatica、dbt(更多偏 ELT)等
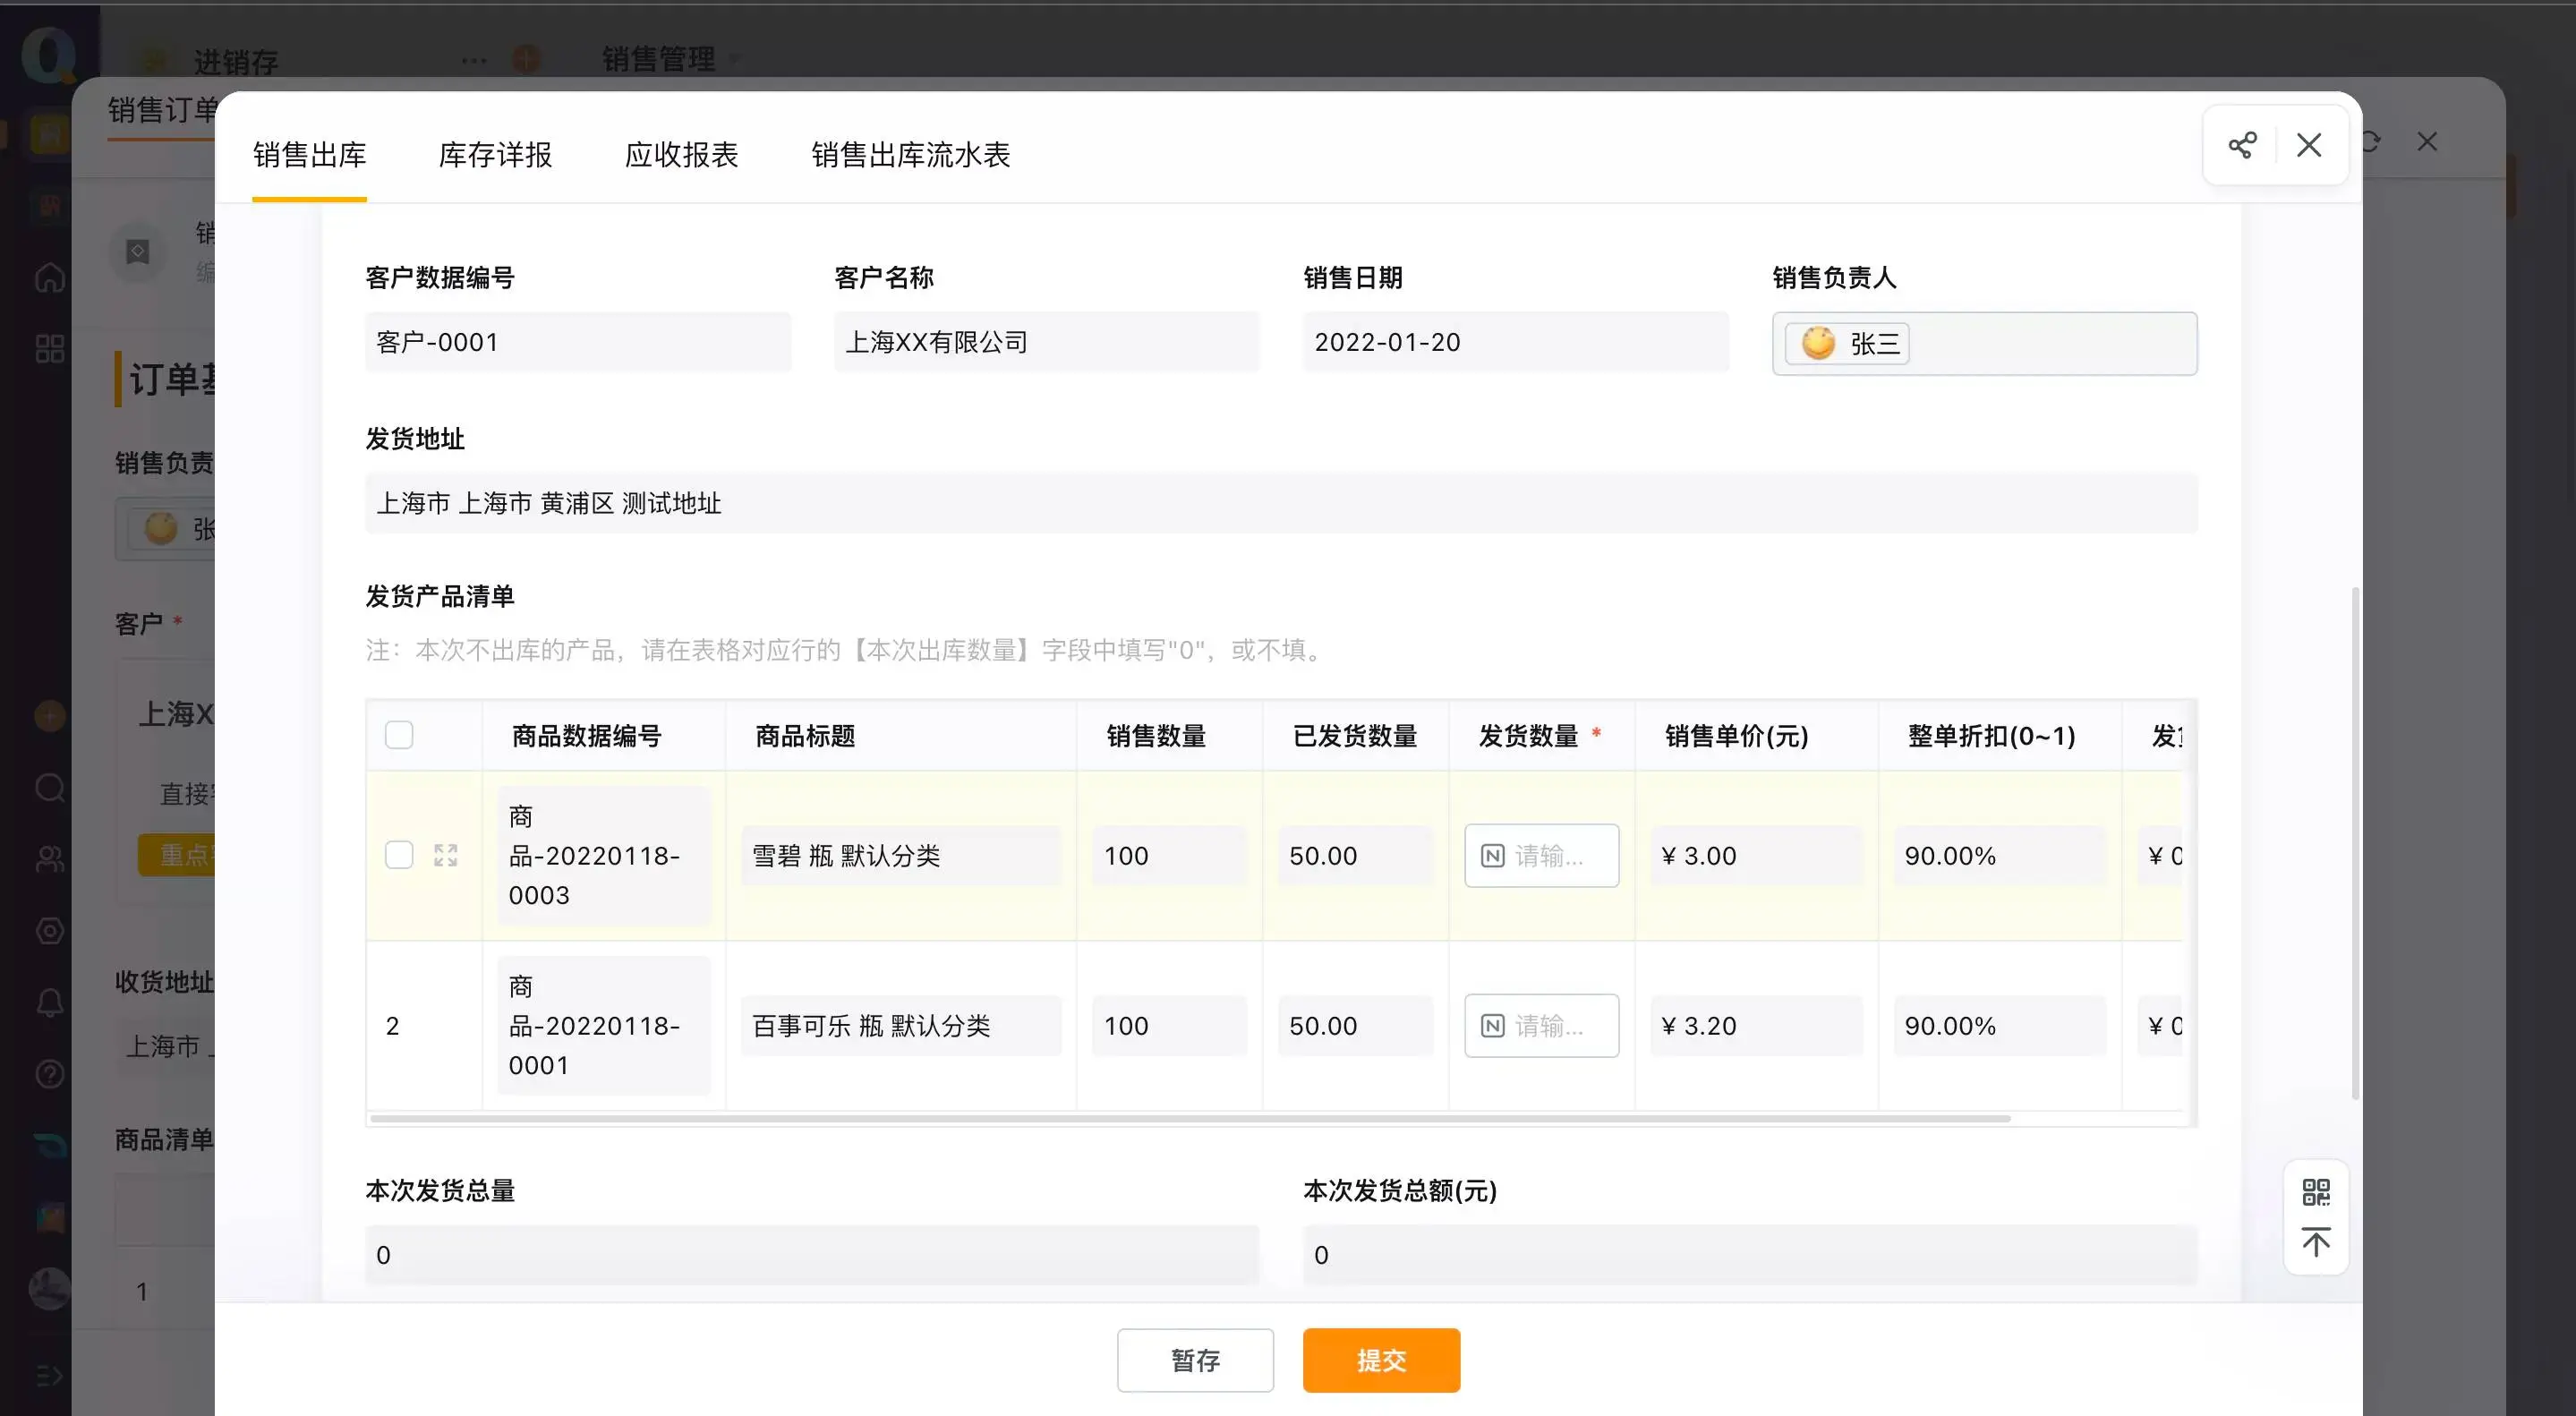
对于中小企业,若缺乏重型数仓工程能力,可以结合 低门槛可配置工具 来搭建业务数据闭环。例如在 仓储、库存、采购销售场景 中,可以使用类似 轻流进销存 的在线模板,将入库、出库、库存、订单等关键数据统一管理,并导出到数据仓库或 BI 工具中分析;其在线表单和流程能力可以减少自建 ETL 系统的开发成本,尤其适合中小团队做数据化管理的快速起步。
六、🚀 性能优化与扩展性设计
6.1 硬件与云资源选型原则
在云环境下,性能与扩展性设计主要关注:
- 存储类型与层级 :热数据 vs 冷数据,SSD vs 对象存储
- 计算资源弹性 :支持按需扩容缩容,按秒/分钟计费
- 网络带宽与跨区域访问 :尤其在多地多中心部署时
云数仓(如 Snowflake、BigQuery、Redshift、ClickHouse 云服务等)通常提供弹性扩展能力,设计时需要重点考虑:
- 表分布策略(Sharding、Cluster Key、Partition)
- 并发查询与队列管理
- 存算分离的成本控制策略
6.2 分区、分桶与索引策略
分区(Partition)是提升大数据量查询性能的关键:
- 按时间分区(最常见):按天/周/月
- 按业务主键或地区分区:需根据查询模式优化
- 避免过度碎片(太细的分区会增加管理和元数据开销)
分桶/分布键(Bucket/Distribution Key)有助于:
- 平衡数据在节点之间的分布
- 减少跨节点数据移动(Shuffled Join)
- 适用于常 join 的维度或事实字段
索引 (在传统数仓或某些列存引擎中)可以优化点查和过滤,但在列存 + 分区架构中,更多依赖:
- 数据压缩和编码
- 统计信息和执行计划优化
- 适当的物化视图(Materialized View)
6.3 预计算与物化视图
对于高频访问、复杂聚合的报表,可使用:
- 预聚合表(DWS 层)
- 物化视图(支持自动刷新或增量刷新)
- OLAP 引擎(如 Apache Druid、ClickHouse、Apache Pinot 等)
典型需求场景:
- 实时经营大盘
- 多维度组合查询(地区 × 渠道 × 品类 × 时间)
- 高频钻取与切片
合理的预计算策略能减少数据仓库压力,提升整体响应速度。
6.4 并发与资源隔离
对于访问量大的企业(如电商大促、促销活动期间),要考虑:
- 不同业务线和用户群的查询隔离(如 Snowflake 的 Virtual Warehouse、BigQuery 的项目隔离)
- 后台批处理与前台查询的资源隔离
- 高优先级报表与低优先级探索性分析的队列控制
通过资源池划分和优先级管理,避免关键报表受“重型 ad-hoc 查询”影响。
七、🧪 数据质量管理与元数据治理
7.1 数据质量的维度与常见问题
数据仓库要满足企业需求,不能只有“有数据”,还必须“有用、可信”。数据质量维度包括:
- 完整性 :字段是否缺失?记录是否缺失?
- 准确性 :值是否正确?是否符合业务规则?
- 一致性 :同一指标在不同表、不同系统是否一致?
- 及时性 :是否按时更新?是否延迟?
- 唯一性 :主键是否重复?
- 可追溯性 :能否追踪数据来源和变更过程?
- 订单金额与支付金额不一致
- 同一客户在不同系统有多个 ID
- 报表指标与财务报表对不齐
- 数据延迟导致运营看板数据滞后
7.2 数据质量监控与规则管理
可通过 质量规则 + 自动检测 来治理:
- 范围检查(如金额 >= 0、日期不超过当前时间)
- 唯一性检查(主键去重)
- 参照完整性检查(外键必须在维度表存在)
- 统计分布监控(异常波动告警)
- 业务规则检查(如订单状态和支付状态组合是否合法)
实现方式:
- 自研数据质量平台
- 开源工具(如 Great Expectations、Soda Core 等)
- 在调度流程中嵌入质量检测任务,失败则中止下游链路
对中小规模应用,例如库存、采购销售管理,可以通过配置化工具将部分数据质量规则固化在业务流程中。例如使用 轻流进销存 这类在线系统时,可以在入库单、出库单、订单数据录入时配置字段校验、流程审批,提前减少错误数据进入后端数据仓库,从源头提升质量。
7.3 元数据管理与数据血缘
元数据(Metadata)是“关于数据的数据”,包括:
- 技术元数据:表结构、字段类型、分区信息、存储位置
- 业务元数据:字段含义、指标口径、业务规则
- 操作元数据:创建时间、更新时间、数据量统计
- 血缘信息:字段从何而来,经过哪些转换
元数据平台的价值:
- 帮助新成员快速理解数据仓库结构
- 提升数据发现效率(搜索表、字段、指标)
- 支撑影响分析(修改字段会影响哪些报表)
- 是数据治理和合规审计的重要基础
八、🔐 安全、合规与权限控制
8.1 安全设计原则
数据仓库往往包含大量敏感数据(客户信息、交易数据、财务数据),必须遵循:
- 最小权限原则 :每个用户仅访问其工作需要的数据
- 分层授权 :按库、表、视图、字段、行级等多维度控制
- 审计可追溯 :所有访问、变更有日志可查
- 脱敏与掩码 :对于敏感字段(如手机号、邮箱、身份证等)进行脱敏展示
8.2 权限模型设计
常见权限模型:
- RBAC(基于角色):按角色赋权,用户继承角色权限
- ABAC(基于属性):结合用户属性、访问上下文条件控制
- 数据级访问控制:
- 行级安全(Row-Level Security)
- 列级安全(Column-Level Security)
示例:
- 销售经理只能看到自己负责区域的客户数据
- 财务人员可以看到订单金额明细,但运营人员仅能看到汇总数据
8.3 合规与隐私要求
需遵守所在地区的法律法规(如 HIPAA、GDPR 等),企业内部可采用:
- 数据分级分类(公开、内部、敏感、机密)
- 对敏感等级数据采用加密存储、传输加密(TLS)、访问控制和脱敏策略
- 定期安全审计与漏洞扫描
九、🧑💻 运维、监控与成本治理
9.1 监控指标体系设计
数据仓库运维监控通常包括:
- 任务运行监控 :成功率、失败率、重跑次数、运行时长
- 数据质量监控 :质量规则通过率、异常告警
- 资源利用监控 :CPU、内存、IO、查询队列、并发数
- 成本监控 (云数仓):存储成本、计算成本、跨区域流量成本
可以建立可视化运维看板,提供:
- 实时任务状态
- 延迟报警
- 资源告警与自动扩缩容策略
9.2 版本管理与变更流程
对数据仓库而言,变更管理至关重要:
- SQL 脚本与数据模型需要 版本控制 (Git 等)
- 使用迁移工具(如 dbt、Liquibase 等)管理表结构升级与回滚
- 重要变更需通过测试环境验证后再进入生产
- 大规模历史数据重算要评估影响,并制定回滚方案
9.3 成本优化策略
特别是在云环境中:
- 为冷数据使用低成本存储层(如对象存储、归档存储)
- 对大表设计合理分区,减少不必要的扫描
- 控制 BI 工具的刷数频率和查询行为(避免高频全表扫)
- 根据使用模式设置按需计算资源和自动暂停机制
对于日常业务数据管理,可以将部分非关键分析需求下沉到业务系统中,例如库存查询、订单跟踪等放在 在线仓库管理系统 中完成,而只将关键汇总数据写入数据仓库,这种方式可以减少数仓压力与成本。像 轻流进销存 一类在线模板支持库存、采购、销售等业务数据在线管理,并可通过导出或 API 与数仓对接,有利于在控制成本的前提下,提升整体数据治理成熟度。
十、📊 结合业务场景:如何让数据仓库真正“好用”
10.1 面向报表与 BI 的设计要点
要让业务人员愿意用数据仓库,必须在“报表层”下功夫:
- 为高频报表设计专用宽表或数据集(ADS 层)
- 与 BI 工具深度集成(如 Tableau、Power BI、Looker、Superset 等)
- 复用公共维度与指标定义,避免报表间口径不一致
- 支持自助分析(拖拽维度与指标),降低对 IT 的依赖
10.2 面向业务流程的数据闭环
数据仓库不是终点,而是数据闭环的一部分:
- 业务数据产生(订单、库存、采购、销售等)
- 数据进入数据仓库,做整合与分析
- 分析结果反哺业务(运营策略调整、库存优化、定价决策)
- 新策略产生新数据,持续优化
例如在供应链与仓储领域:
- 数据仓库可以分析 库存周转率、缺货率、滞销品、畅销品 等
- 结合仓库管理系统(WMS)的数据,可以优化补货策略与库位布局
- 将分析结果通过 API 写回业务系统,支持自动补货、智能预警等功能
若企业在仓储环节尚未信息化,构建数据仓库前,通常会先搭建电子化、结构化的业务数据底座。借助 轻流进销存 这类在线模板,可以快速搭建入库、出库、盘点、库存台账等功能,并预留数据接口,为后续数仓建设提供标准、干净的业务数据来源。
十一、🔮 总结与未来趋势展望
11.1 关键要点回顾
围绕“数据仓库设计和管理要求,如何高效满足企业需求”,整体可以归纳为以下几条原则:
- 从业务出发
- 从决策问题、指标体系、使用人群出发做需求分析
- 明确数据仓库在企业架构中的角色,与数据湖、数据集市合理分工
- 架构与分层清晰
- 采用 ODS/DWD/DWS/ADS 等分层,理顺责任与依赖
- 支持后续扩展与演进(集中式 → 领域化 → 湖仓一体)
- 建模方法合理
- 综合使用维度建模、3NF、Data Vault 等方法
- 在主题层构建易用的维度模型,支撑 BI 与自助分析
- ETL/ELT 标准化与自动化
- 抽取稳定、转换透明、调度可追踪
- 数据质量规则融入全流程,避免“垃圾进、垃圾出”
- 性能与成本平衡
- 通过分区、分布键、物化视图、预聚合提升性能
- 利用云数仓弹性能力和精细化监控控制成本
- 数据质量、元数据与安全治理
- 定期监控质量、统一指标口径、维护数据血缘
- 落实权限控制和合规要求,保障数据安全可信
- 紧贴业务场景形成数据闭环
- 面向实际业务流程和报表需求做优化
- 将分析结果反馈业务系统,实现持续改进
11.2 未来趋势与演进方向
未来几年,数据仓库设计与管理会呈现以下趋势:
- 湖仓一体与统一计算引擎
- 通过统一存储和引擎,减少数据移动与复制
- 支持批流一体、结构化与非结构化数据统一分析
- 数据网格(Data Mesh)与领域数据产品
- 按业务域划分数据责任,推动“数据即产品”的理念
- 要求更好的元数据、数据目录与标准化接口支持
- 自动化与智能化治理
- 智能血缘分析、自动建模建议、查询优化建议等
- 自动发现数据质量问题、自动调优资源分配
- 实时数仓和流批一体
- 结合流式引擎(如 Flink、Kafka Streams)和数仓
- 满足实时监控、大屏分析、实时风控等需求
- 与业务应用的深度融合
- 通过 API、嵌入式分析(Embedded Analytics)等方式
- 将分析结果嵌入日常操作系统,实现真正的数据驱动
在实践中,建议企业循序渐进: 先通过电子化和结构化管理业务数据(如利用在线进销存或 WMS 模板管理仓库与库存),再逐步搭建数据仓库、引入 BI 分析和高级建模,这样既控制建设风险,又不断释放数据价值。 如果你正计划在仓储与库存管理场景中打通业务数据与分析数据,可以考虑使用 轻流 WMS 仓库管理系统模板 (在线地址:<
如果希望把业务表单、审批流程、数据联动和经营看板统一到一套可调整的业务流程中,轻流可以通过无代码表单、流程、权限、数据联动和看板,按实际业务快速搭建可持续调整的管理应用;可立即体验轻流。
常见问题
本文由轻流知识中心编辑整理
轻流(Qingflow)是一体化 AI 无代码平台,持续围绕生产管理、进销存、设备巡检、 CRM、OA 等企业数字化场景输出实操内容,帮助团队更快完成系统选型、 流程优化与落地搭建。